
Lokalny bezpłatny Claude i Codex z Ollamą
Wymagania wstępne
- Maszyna z co najmniej 16 GB pamięci RAM (zalecane 32 GB+ dla lepszej wydajności z większymi modelami).
- System operacyjny: macOS, Linux lub Windows (Ollama obsługuje wszystkie).
- Zainstalowany Node.js (do instalacji narzędzi CLI, takich jak Claude Code i Codex). Możesz go pobrać z oficjalnej strony Node.js, jeśli nie jest jeszcze zainstalowany.
- Wystarczająca ilość miejsca na modele (modele mogą zajmować kilka GB).
- Dla optymalnej wydajności pomocna, ale nie wymagana, jest karta graficzna (NVIDIA lub Apple Silicon); działa również tylko na procesorze.
Krok 1: Zainstaluj Ollama
Ollama to podstawowe narzędzie do uruchamiania lokalnych modeli AI. Pobierz i zainstaluj je za pomocą następującego polecenia w terminalu:
curl -fsSL https://ollama.com/install.sh | sh Zweryfikuj instalację, uruchamiając:
ollama -v Powinno to wyświetlić wersję Ollama (upewnij się, że jest to v0.15 lub nowsza, aby uzyskać obsługę ollama launch).
Krok 2: Pobierz odpowiedni model kodowania
Ollama potrzebuje lokalnego modelu do zasilania Claude Code i Codex. Wybierz model na podstawie swojego sprzętu (RAM/VRAM). Oto zalecenia dotyczące zadań kodowania:
- Dla 16-32 GB pamięci RAM (mniejsze modele, szybsze na procesorze): qwen2.5-coder:7b (dobry balans prędkości i jakości).
ollama pull qwen2.5-coder:7b - Dla 32 GB+ pamięci RAM (większe modele, lepsza dokładność): devstral-small-2 (24B parametrów) lub qwen3-coder:30b.
ollama pull devstral-small-2 - Opcja wysokiej wydajności (skwantyzowana dla wydajności): glm-4.7-flash:q8_0 (wymaga około 19-24 GB VRAM dla najlepszej prędkości).
ollama pull glm-4.7-flash:q8_0 Jeśli pobieranie się nie powiedzie (np. błąd sumy kontrolnej), usuń model i spróbuj ponownie:
ollama rm <model-name> ollama pull <model-name> Większe modele zapewniają lepszą pomoc w kodowaniu, ale mogą działać wolniej na ograniczonym sprzęcie.
Krok 3: Skonfiguruj i używaj Claude Code z Ollama
Claude Code to asystent kodowania AI firmy Anthropic, ale możesz go uruchamiać lokalnie z modelami Ollama zamiast płacić za dostęp do API.
Instalacja
Zainstaluj Claude Code CLI globalnie przez npm:
npm install -g @anthropic-ai/claude-code Konfiguracja
Opcja 1: Użyj ollama launch dla łatwej konfiguracji (zalecane):
ollama launch claude --model <model-name> Na przykład:
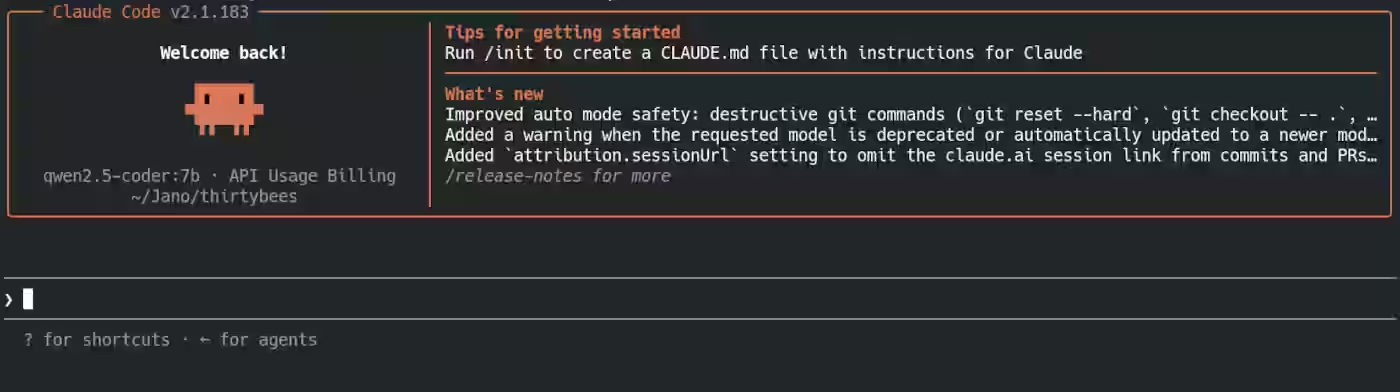
ollama launch claude --model qwen2.5-coder:7b To uruchamia Claude Code, konfiguruje go do używania twojego lokalnego modelu i prosi o potwierdzenie zaufania (wpisz "yes").
Opcja 2: Ręczna konfiguracja (dodaj do pliku ~/.bashrc lub ~/.zshrc):
export ANTHROPIC_AUTH_TOKEN="ollama"
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL="http://localhost:11434/v1"
Przeładuj swoją powłokę:
source ~/.bashrc # lub ~/.zshrc Następnie uruchom:
claude --model <model-name> Na przykład:
claude --model devstral-small-2 Użycie
- Po uruchomieniu wejdziesz w interaktywną sesję. Wpisz swoje zapytanie dotyczące kodowania (np. "Napisz funkcję Pythona do sortowania listy").
- Użyj klawisza Tab, aby przełączać tryby (np. planowanie vs. tworzenie kodu).
- Naciśnij Ctrl+P, aby uzyskać opcje, takie jak udostępnianie sesji lub przełączanie modeli.
- Wyjdź za pomocą Ctrl+C.
- Działa w pełni offline i prywatnie na Twojej maszynie.
Krok 4: Skonfiguruj i używaj Codex z Ollama
Codex (inspirowany oryginalnym modelem kodu OpenAI, często używanym w narzędziach takich jak GitHub Copilot) można uruchamiać lokalnie za pomocą narzędzia CLI zintegrowanego z Ollama.
Instalacja
Zainstaluj Codex CLI globalnie przez npm:
npm install -g codex Konfiguracja
Użyj ollama launch do konfiguracji:
ollama launch codex --model <model-name> Na przykład:
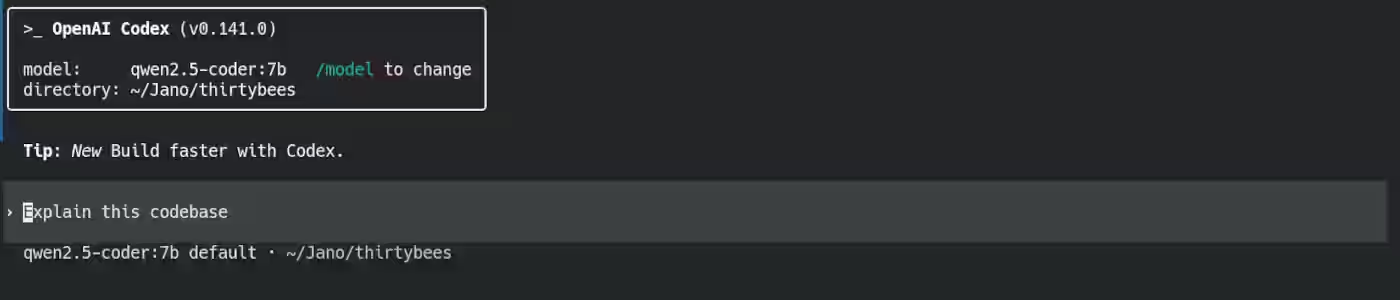
ollama launch codex --model glm-4.7-flash:q8_0 To skonfiguruje i uruchomi Codex z Twoim lokalnym modelem. Potwierdź zaufanie, jeśli zostaniesz o to poproszony.
Do konfiguracji bez uruchamiania:
ollama launch codex config Wybierz swój model i zapisz.
Użycie
- W interaktywnej sesji wpisz polecenia takie jak "Wygeneruj funkcję JavaScript do wywołań API".
- Nawiguj za pomocą klawisza Tab, użyj Ctrl+P dla opcji menu.
- Obsługuje uzupełnianie kodu, wyjaśnianie i generowanie.
- W pełni lokalne i darmowe, nie wymaga kluczy API.
- Wyjdź za pomocą Ctrl+C.
Wskazówki i rozwiązywanie problemów
- Wydajność: Zacznij od mniejszych modeli, jeśli Twój komputer jest wolniejszy. Modele skwantyzowane (np. kończące się na :q8_0) są szybsze.
- Przełączanie modeli: Uruchom ponownie z innym flagą --model.
- Hybryda chmurowa: Jeśli lokalne jest zbyt wolne, wypróbuj modele chmurowe, takie jak minimax-m2.1:cloud (pobierz za pomocą ollama pull minimax-m2.1:cloud), ale pamiętaj o potencjalnych kosztach po przekroczeniu darmowego limitu.
- Błędy: Upewnij się, że Ollama działa (w razie potrzeby uruchom ollama serve). Sprawdź użycie pamięci RAM za pomocą narzędzi systemowych.
- Aktualizacje: Zachowaj aktualność Ollama, aby korzystać z nowych funkcji i obsługi modeli.
- Ta konfiguracja zastępuje płatne usługi, takie jak API Anthropic lub OpenAI, zachowując wszystko prywatne i bezpłatne.